创建 AI 客户端
import web.rest.aiChat;
var aiChat = web.rest.aiChat({
    key = '这里指定 API 密钥';
    url = "这里指定大模型接口地址";
    model = "这里指定模型名称"; //llama.cpp 本地模型可以省略
    temperature = 0.1; //可选指定温度
    maxTokens = 16384; //可选指定最大回复长度
    protocol = null; //可选指定 API 接口协议类型
    extraParameters = {}; //可选增加的`自定义参数`
} )
构造参数表字段说明:
web.rest.aiChat 的构造参数只能指定上面列出的字段,并且都是按小驼峰风格命名。调用时会自动转换为 API 接口的对应字段名,例如 topP 会转换为 top_p , 而 maxTokens 字段会根据接口不同改转换字段名为 max_tokens 或者 max_completion_tokens。
maxTokens 通常包含推理思考时的消耗,个别模型的默认 maxTokens 比较小,如果在思考时达到固定长度就终止输出则应显式指定更大的 maxTokens 。
topP 字段是可选的,一般建议指定 temperature 的值而不是指定 topP 的值。请参考:关于 temperature 参数
支持思考的推理模型通常要求将 temperature 设为 1。 例如 Gemini 3.x Flash 或者 Gemini 3.x Pro 必须设为 1,设为其他值生成质量会显著下降。 这是因为思考类模型需要获取更多可能性以生成最优结果。 OpenAI 的 GPT5.x 在开启思考模式时强制要求设为 1 。 Claude 4.x 开启思考时 temperature 只能设为 1,Opus 4.7 开始不允许用户指定 temperature 参数(aardio 会自动处理) DeepSeek 4 在开启思考时会忽略 temperature 的值。
url 字段用于指定接口地址。
OpenAI 或 Anthropic 接口 URL 通常以 "/v1" 结尾。
如果接口 URL 的路径部分为空或 /anthropic 并且尾部不是 / 则会默认添加 /v1 后缀。
因此在 aardio 中填写以下格式的接口地址都是允许的:
https://api.deepseek.com
https://api.deepseek.com/v1
https://api.deepseek.com/anthropic
https://api.deepseek.com/anthropic/v1
https://generativelanguage.googleapis.com/v1beta/openai
https://api.deepseek.com/v1/chat/completions#
网址后的 # 可显示指定精确的对话接口地址,阻止调用 message 方法时自动追加 chat/completions 等路径后缀。
protocol 字段一般不必指定,默认会自动选择接口类型。
protocol 可指定的值:
第三方平台提供的 Claude 模型基本上都已转换为了 openai 兼容接口。
如果不指定 protocol (或为 null 值)则会根据接口 URL 自动设置 protocol 。 如果接口 URL 中包含单词 "anthropic" 则 protocol 的默认值也会设为 "anthropic"
自定义接口请求参数: 💡
如果在 web.rest.aiChat 的构造参数中添加可选的 extraParameters 字段则会设为 aiChat 对象 extraParameters 属性的初始值。aiChat.extraParameters 属性可选指定一个表对象( table ),表中的键值对将作为自定义参数原样附加到所有请求参数中。
AI 接口设置窗口( web.rest.aiChat.settingForm )的
自定义参数对应的就是这里的extraParameters字段。
可选使用 aiChat.extraUrlParameters 指定一个表,表中的键值对将作为 URL 参数添加到所有请求网址中。
示例:
aiChat.extraParameters = {
    enable_thinking = true;
    thinking_budget = 1024;
}
注意 extraParameters 或 extraUrlParameters 里的字段名会保持原样发送给服务器,aardio 不会转换字段的命名风格。
自定义参数仅合并表遵守以下规则:
如果自定义参数中添加
{"tools": [{"type": "web_search"}]}会自动合并到 AA 原来的 tools 定义中( tools 字段只能是纯数组或 null 值)。使用
protocol="responses"时,input、instructions、store、stream、background、conversation、previous_response_id属于当前 HTTP 事务的内部状态字段,由messages()内部构造,不能通过 extraParameters 覆盖。其中每次请求都固定使用store=false,并在本地重放当前工作线程中的完整临时链。
自定义 HTTP 请求头:
在 web.rest.aiChat 的构造参数中可以使用 extraHeaders 字段指定 extraHeaders 属性的初始值。 也可以在创建 web.rest.aiChat 对象后再指定 extraHeaders 属性。
web.rest.aiChat 的值应当是一个表对象,使用名值对指定 HTTP 请求头的一个或多个名值对。 在 web.rest.aiChat.settingForm 创建的设置对话框中,可以使用 JSON 语法自定义 extraHeaders 的值。
推理参数
reasoning 字段用于指定推理选项,最常用的是使用 reasoning.effort 指定 推理强度,例如 reasoning = { effort = "high" } 。不同协议指定推理选项的实际参数名与格式并不一致,web.rest.aiChat 会根据选择的协议转换为合适的格式,对于 OpenAI 接口这 reasoning.effort 将被转换为请求参数中的 reasoning_effort 。
更多细节请参考后面的 设置推理强度
设置超时
web.reat.aiChat 默认的超时设置为 连接超时=15000,请求超时=30000,接收超时=600000,
这适合一般的非流式调用。
对于流式调用,需要减少接收超时,示例:
//连接超时=15000,请求超时=30000,接收超时=60000 单位毫秒
aiChat.setTimeouts(15000,30000,60000)
流式接口接收间隔较短,并且通常有心跳保活措施,接收超时不宜过大。 但部分模型将加密思考内容仅发送摘要则间隔较慢,因此接收超时也不宜过小。 因此建议将发送超时设为 60000 毫秒(60 秒)。
创建聊天消息对列,保存对话上下文。
var msg = web.rest.aiChat.messages();

//可调用 msg.system() 函数添加系统提示词。
msg.system("你是桌面智能助手。");

//添加用户提示词
msg.prompt( "请输入问题:" );
也可以用模拟 AI 的角色添加回复到消息对列
//模拟 AI 角色
msg.assistant("请输入问题:" );
这样自问自答的历史消息可以起到小样本学习的作用,让 AI 后面的回复更符合要求,小样本学习的效果有时候会非常好。
向 AI 服务器发送请求,接收 AI 回复
var resp,err,errCode = aiChat.messages(msg,
    function(deltaText,reasoning,reserved){

        /*
        reasoning 可能为 null 或字符串。
        推理模型会首先通过 reasoning 参数输出推理过程(同样是增量字符串),同时 deltaText 为空字符串 "" 。
        reserved 是保留参数,必须忽略。
        */
        if(reasoning) return;

        //回复完成则 deltaText 为 null , 参数为 null 时应保证幂等性(连续调用不重复执行/无副作用)
        console.writeText(deltaText)

        //如果需要输入增量输入到目标窗口
        //key.sendString(deltaText)

        //显示为屏幕汽泡提示,支持增量文本。
        //winex.tooltip.popupDelta(deltaText)
    }
);
调用 ai.messages 就开始对话,如果参数 @2 指定了 SSE 流式回调函数,就自动切换到 SSE 流式调用( 打字效果, 逐步渐进式回复增量文本 ),服务器每次发送增量文本都会传入 deltaText 参数,当 AI 回复结束时 deltaText 为 null 。
aiChat.messages 有两种不同的用法,返回值也有所不同:
流式请求: 如果参数 @2 指定了 SSE 回调函数,则 aiChat.messages 调用成功时返回值 resp 为 true ,失败则为 false 或 null 值。
流式请求时如果第一个返回值为 null, 第二个返回值(err) 为字符串,并且第三个返回值(errCode)为 0 , 这表示 AI 回复未完成,但没有发生其他错误。 如果 err 是空字符串 "" 则表示没有收到有效的回复正文(思考内容与工具调用除外,也就是只有过程没有结果)。
非流式请求: 如果未指定 SSE 回调函数,则禁用 SSE 流式回复并直接获取最终结果。请求成功时返回值 resp 为解析服务器回复 JSON 数据的表对象。
非流式回复返回的 resp 对象示例:
{
    "choices":[
        {
            "finish_reason":"stop",
            "message":{
                "content":"AI 最终回复内容",
                "role":"assistant"
            }
        }
    ]
}
choices[1].message.content 为 AI 回复的最终内容,其他字段则因不同的接口可能会不一样(一般也用不上)。
如果只需要非流式回复的正文,可以调用 ai.getText(msg)。此函数内部仍调用 messages(msg),但能够自动兼容所有支持的协议,并直接提取与返回可见正文:
var text,err,errCode = ai.getText(msg);
if(text !== null) print(text);
如果请求失败则返回值 resp 为 null 或 false 等非真值,而返回值 err 包含可能的错误字符串。web.rest.aiChat 继承自 web.rest.client,所以也可以用 aiChat.lastResponseError() 获取错误对象(解析 JSON 格式错误信息得到的对象),用 aiChat.lastResponseString() 获取服务器的原始错误信息(字符串对象),或者用 aiChat.lastStatusCode 获取 HTTP 响应状态码。更多用法请参考 使用 web.rest 客户端
可用 ai.getText(prompt) 或 ai.getText(prompt) 直接发送用户提示词(字符串),aardio 会自动转换为 web.rest.aiChat.messages 格式(消息数组)。
示例:
import web.rest.aiChat;

var ai = web.rest.aiChat(
    url = "https://index-translate.bilibili.com/v1";
    model = "Index-Translate-35B-A3B";
)

var text,err = ai.getText("仅翻译:Occam's Razor");
print(text);
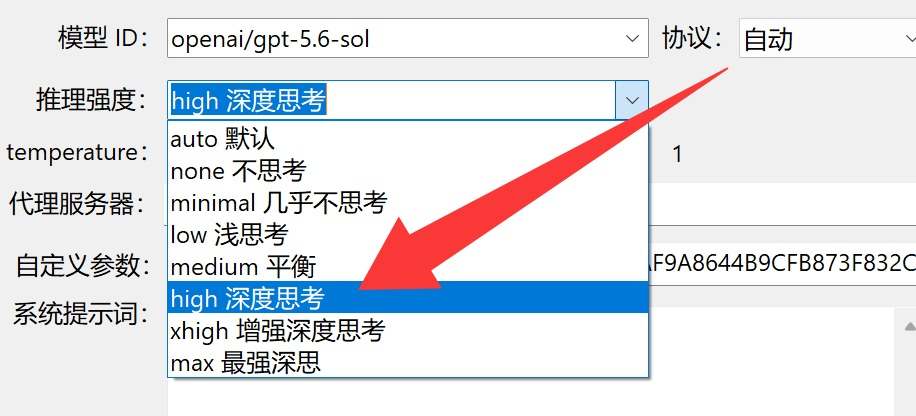
主流大模型可选的推理强度如下:
auto ⇒ 默认(不指定思考强度 / 默认设置)none ⇒ 不思考 (直接回复)minimal ⇒几乎不思考(最弱推理强度)low ⇒浅思考medium ⇒平衡模式(中等推理强度)high ⇒深度思考xhigh ⇒增强深度思考max ⇒ 最大强度具备深度推理能力的现代大模型通常都可以指定推理强度,但并非所有模型都支持以上全部设置值。个别模型会将一些推理强度映射到其他强度,也有一些模型仅支持思考开关而但不能自定义推理强度。一些第三方平台会自动转换这个参数以兼容不同模型,web.rest.aiChat 也会进行兼容性转换(并不保证支持所有模型)。
import web.rest.aiChat;
var aiChat = web.rest.aiChat({
    key = '这里指定 API 密钥';
    url = "这里指定大模型接口地址";
    model = "openai/gpt-6-sol";
    reasoning = {
        effort = "high"
    }
} )
web.rest.aiChat 会根据当前选择的接口协议自动转换参数。对于 OpenAI 接口, reasoning.effort 会被转换为转换为请求参数中的 reasoning_effort 。
个别模型可选指定
reasoning.maxTokens以限制推理消耗的最大 tokens 。 但这种明确限制最大 token 数量的方式已逐渐被淘汰,现代模型已不建议使用。个别模型使用
thinking字段设置思考选项,aardio 接受此参数但不会做任何转换,并将其直接发送给服务器。
aardio 编写的程序(例如 aardio autos)通常使用标准库 web.rest.aiChat.settingForm 创建 AI 接口设置接面。这个设置界面的 推理强度 选项会被转换为上述的 reasoning.effort 的字段。
在 AI 设置界面的 API 配置右键菜单项点
复制分享链接可获得 ai+ 格式链接。在 aardio 代码编辑器右键菜单点击粘贴与更正可识别 ai+ 链接并自动生成调用 API 接口的示例代码。
medium 这个名词错误地暗示了它适合大多数任务,但这通常是一个误解。
对于 AA(aardio autos) 这类支持交错思考的智能体(Agent),推理强度至少要设为 high 或者更大的 xhigh,max 。
也可以通过 AI 设置对话框的 自定义参数 用 JSON 指定推理强度,例如 DeepSeek Pro 4 可以将 自定义参数 指定为:{"reasoning_effort":"high","thinking":{"type":"enabled"}}。这相当于在代码中修改 web.rest.aiChat 的 extraParameters 参数,aardio 会将自定义参数直接发送给服务端(不会进行任何转换)。要使自定义 JSON 里的 reasoning_effort 生效,则必须将它上面的推理强度选项设为auto (也就是忽略这个选项)。
如何选择:
max 或 xhighhigh根据 AI 的表现调整推理强度:
一句话总结就是:强度越小越擅长做减法(更懒),强度越大越擅长做加法(更努力)。高强度推理消耗的 tokens 也会更多。
我们应当根据 AI 的表现与具体任务选择与调整合适的推理强度,具体情况具体对待。
使用最大推理强度时可以适度关注 AI 输出的思考内容,避免 AI 跑偏与过度设计。例如在 AA(aardio autos) 里可以停止思考过程,然后输入临时纠偏的用户提示词(仅注入交错思考),再点击继续,这种人机合作的模式通常会带来非常好的效果。
web.rest.aiChat 默认使用 OpenAI 兼容接口。 基本上大部分大模型都使用 OpenAI 兼容接口,例如 DeepSeek 。
调用 OpenAI 流式接口示例:
import console.int;
console.showLoading(" Thinking ");

//1. 创建 AI 客户端
//---------------------------------------------------------------------
import web.rest.aiChat;
var aiChat = web.rest.aiChat(
    key =   'YOUR_API_KEY';
    url = "https://api.deepseek.com/v1";
    model = "deepseek-v4-pro";
    temperature = 1;
    reasoning = {effort: "high"}; // "none" 关闭思考
    //maxTokens = 16384;
)

//2. 创建消息队列
//---------------------------------------------------------------------
var msg = web.rest.aiChat.messages();
msg.prompt( "请介绍你自己" );

//3. 第三步:发送请求。
var resp,err = aiChat.messages(msg,
    function(deltaText,reasoning){

        if(reasoning) {
            return console.writeColorText(reasoning,0xA);
        }

        //回复完成则 为 null 。
        console.writeText(deltaText)
    }
);

console.error(err);
OpenAI GPT 6 的 responses 协议提供了一些服务端工具,以调用搜索工具为例:
在 aardio 代码中只要在 web.rest.aiChat 的构造参数表中直接添加 "tools": [{"type": "web_search"}] 即可。使用 tools 字段即可以指定本地工具也可以指定服务端工具,参考 调用本地函数
示例:
var aiClient = web.rest.aiChat({
    key="API_KEY";
    model="gpt-6-sol";
    protocol="responses"; // 必须是 responses 协议才支持服务端工具
    reasoning={
        effort="xhigh"
    };
    tools=[{"type":"web_search"}];
    url="https://api.openai.com/v1"
})
DeepSeek 使用 responses 协议时也可以支持
tools=[{"type":"web_search"}]
如果在自定义参数(extraParameters)与请求参数中都指定了 tools 字段 ,只要 tools 的值是纯数组(也就是用[]构造数组),aardio 会自动合并 tools 字段。需要注意:如果本地工具也提供了联网搜索工具,又同时启用了服务端 web_search 工具,这可能会让 AI 产生不必要的选择成本与困惑。
OpenAI 支持自动前缀缓存,通常不需要额外设置参数。
但是,通过中转服务商请求 OpenAI 接口可能出现缓存功能失效,这是因为中转服务商可能轮换了不同的 key 发送请求。这会导致费用大幅增加。
解决方法是在自定义参数中显式指定 prompt_cache_key 字段。
示例:
var aiChat = web.rest.aiChat(
    key =  'API_KEY';
    url = "https://openrouter.ai/api/v1";
    model = "openai/gpt-6-sol";
    temperature = 1;
    reasoning = {effort = "high"};
    extraParameters  = {
        prompt_cache_key = "your_unique_session_id_12345";
    };
)
注意如果多用户共享相同的 prompt_cache_key 会被路由到固定的 GPU 机器,如果同一缓存键并发请求过多(通常超 15次/分钟),系统会触发溢出路由,从而降低缓存效果。因此应当避免多用户使用相同的 prompt_cache_key。
对于中转服务商,可以考虑对 API key 加盐然后计算 sha256 哈希作为 prompt_cache_key,例如:
prompt_cache_key = crypt.sha256( config.key ++ io._exepath )
GPT5.5 的提示缓存(Prompt Caching)是完全免费写入的,便 GPT 5.6 写缓存会收费。总的来说指定 prompt_cache_key 通常都会大幅降低成本。
注意 GPT5.6 开始已经废弃
prompt_cache_retention,缓存时间建议保值默认即可。
将构造参数 protocol 指定为 "responses" 即可使用 Responses API:
import web.rest.aiChat;
var ai = web.rest.aiChat(
    key = 'YOUR_API_KEY';
    url = "https://api.openai.com/v1";
    model = "gpt-5";
    protocol = "responses";
    reasoning = {effort = "high"};
)

var msg = web.rest.aiChat.messages();
msg.system("你是桌面智能助手。");
msg.prompt("请介绍你自己");

var result,err = ai.messages(msg);
if(result) print(result.output_text);
Responses 分支支持普通 HTTP 请求与 HTTP SSE,不实现 WebSocket / Realtime API。每个请求固定发送 store=false,不使用 previous_response_id,而是完整重放本地消息。
在单次连续工具调用链中,服务端返回的原生 reasoning、function_call 以及本地生成的 function_call_output 会临时保留在调用方传入的工作消息副本中,以支持无状态续接和中止后继续。工具链正常结束后,界面或持久历史只应保存标准 user/assistant 可见消息;不要把这份临时原生链写入普通会话存档。
当配置了本地工具时,客户端会请求 reasoning.encrypted_content 并原样回放服务端返回的原生 output Items。工具回传请求仍会重新收集当前 system/developer 消息作为顶层 instructions,因此动态增加的系统提示词可在下一次请求生效。
调用 OpenAI 官方的 GPT 系列大模型时,无论是不是走中转站都应当明确选择
responses协议,否则 aardio 可能默认选择经典的openai协议(chat/completions接口)。一些中转站的chat/completions接口实际是转换为responses协议,这会导致丢失一些重要的字段,例如思考签名,在执行交错思考与工具调用时会丢失加密的思维链,导致 AI 出现记忆断片,执行能力大幅下降。一个例外是 OpenRouter 应当保持默认或选择
openai经典协议(Chat Completions API)。OpenRouter 会将不同厂商的不同格式的推理明细规范化为 reasoning_details 字段 —— web.rest.aiChat 可自动识别并支持此字段。虽然 OpenRouter 也可以支持responses协议,但并非最佳选择。
支持 OpenAI 兼容接口:
也可以支持 Google 自家的协议接口:
Vertex 密钥设置: #
使用 Vertex 接口时 web.rest.aiChat 构造参数表中的 key 字段需要指定 GCP 密钥数据。
打开「 Vertex AI 控制台 » 主菜单 » IAM 和管理 » 服务账号」 创建并下载 JSON 格式密钥 。
GCP 密钥数据应当是一个表对象或者 JSON 格式字符串( 密钥的第一个字符必须是 { )。
GCP 密钥数据主要字段说明:
token_uri - 必须指定为 URL,GCP 秘钥数据中自带。client_email - GCP 秘钥数据中自带。private_key - PEM 格式的私钥。request_uri - 如果存在这个字段,则以其值作为请求访问令牌的 URL,否则请求 token_uri。project_id - 如果存在这个字段,并且接口 URL 的域名为 generativelanguage.googleapis.com
则会重新合成正确的接口 URL。region - 可选指定此字段用于合成新的接口 URL,不指定则默认为 "global"。 如果 key 指定 GCP 密钥数据则 web.rest.aiChat 会自动获取 GCP 访问令牌,并且默认会跨线程缓存访问令牌以避免重复获取令牌。也可以自行调用标准库 web.rest.gcp.jwtBearerToken 提前获取访问令牌。
自定义思考配置:
示例:
import web.rest.aiChat;
var aiChat = web.rest.aiChat(
    key =   "密钥";
    url = "https://generativelanguage.googleapis.com/v1beta/";
    model = "gemini-3-flash-preview";
    reasoning = {effort = "high"};
)
如果 reasoning.exclude 不为 true 则输出思考过程。
示例:
例如用 aardio 向 AI Studio 接口 https//:generativelanguage.googleapis.com/v1beta/models/gemini-3.6-flash:generateContent?key=YOUR_API_KEY 发送请求的代码如下:
import web.rest.aiChat;

// 1. 创建 AI 客户端。
var aiChat = web.rest.aiChat(
    key = "YOUR_API_KEY";
    url = "https://generativelanguage.googleapis.com/v1beta";
    model = "gemini-3.6-flash";
    //proxy = "socks=127.0.0.1:1081"; //代理服务器
    //protocol = "google"; //generativelanguage.googleapis.com/v1beta 默认使用 Google 协议
);

// 2. 创建消息队列
var msg = web.rest.aiChat.messages();
msg.prompt("你好,请用中文介绍一下你自己。");

// 3. 发送请求,如果没有提供第二个回调函数参数,则会禁用流式回复并等待服务器返回完整结果
var resp, err = aiChat.messages(msg);
print(resp.candidates[1].content.parts[1].text); //Google 协议返回的数据结构与 OpenAI 不同
Gemini 3.x 系列模型的 temperature 只能设为 1,不建议改动
import web.rest.aiChat;
var aiChat = web.rest.aiChat(
    key = '密钥';
    url = "https://api.anthropic.com/v1";
    model = "claude-opus-5-5";
    protocol = "anthropic";//指定使用 Anthropic 接口协议,也就是 Claude 大模型官网接口
    reasoning = { // 不指定 reasoning 则使用默认值
        effort = "max"; //设为 "none" 关闭思考
        // exclude = true; //不显示思考过程
    }
)
如果接口网址包含 anthropic 也会自动切换为 Anthropic 协议(可以省略 protocol 字段)。
reasoning.exclude 默认值为 false , 即使 Claude Opus 4.7+ 也一样。
Anthropic 官方接口可在 自定义参数 中添加 {"cache_control":{ "type":"ephemeral"}} 以开启全局自动缓存。需要注意 Anthropic 官方接口写入缓存是收费的,缓存机制也有点坑。尤其是第三方中转站通常无法正常支持缓存,添加 {"cache_control":{ "type":"ephemeral"}} 不但不能节省费用,反而可能会导致费用增加。
Anthropic 原生 web_search_20260209 是服务端工具,不是本地 function calling。可与客户端定义的函数工具同时使用:
import web.rest.aiChat;
var ai = web.rest.aiChat(
    key = '<api_key>';
    url = "https://api.anthropic.com/v1";
    protocol = "anthropic";
    model = "claude-opus-5-5";
    tools = [{type="web_search_20260209";name="web_search"}];
);
使用 aardio 编写的 AI 工具时,无须修改它内置的工具定义,只需在 AI 接口设置 » 自定义参数中添加 {"tools":[{"type":"web_search_20260209","name":"web_search"}]} 即可( 如果内置 tools 定时是纯数组则可自动合并 )。可选在搜索工具声明中设置 "allowed_callers":["direct"],指定直接调用;省略时采用 Anthropic 的默认调用方式。代码不自动增加任何 anthropic-beta 请求头,也无须手动声明代码执行工具。AA(aardio autos) 已经内置了联网工具,不建议再添加模型自带的 web_search 工具,以避免增加 AI 的选择成本与不必要的困惑。
搜索结果、caller、encrypted_content 与引用元信息只在当前工具链中原样回送:与本地工具交错时按服务端返回的块顺序发送,流式的 server_tool_use.input 参数也会完整组装;服务端返回 pause_turn 时会保存本轮原生 assistant 块并自动续传(最多五次)。暂停响应写入同一工作队列,并通过 afterToolCalling 回调提供异常恢复检查点;达到续传上限时也保留刚收到的暂停响应。在 AA 中,这些数据只进入工作线程的临时工具链及必要时的异常恢复链,不进入界面侧的通用 role/content 历史;独立调用 messages() 时,本地工具和服务端续传都会修改传入的工作消息队列,调用方应将其与普通 UI 历史分开。后续独立轮次不会自动带上上一轮的加密搜索结果,因此不保证跨轮精确引用;流式回调仅输出可见正文,不负责在 UI 展示引用。
对于 Anthropic 官方的最新的 Claude 系列模型, 需要连续对话/交错思考的 Agent 应用建议启用隐式缓存。
AA(aardio autos)只 需在接口设置 » 自定义参数中添加 {"cache_control":{"type":"ephemeral"}}。
aardio 代码中的写法:
import web.rest.aiChat;
var ai = web.rest.aiChat(
    key = '<api_key>';
    url = "https://api.anthropic.com/v1";
    protocol = "anthropic";
    model = "claude-opus-5-5";
    extraParameters={
        cache_control={
            ["type"]="ephemeral"
        }
    }
);
在 AA 里 Anthropic 协议 + Claude 模型将会默认启用隐式缓存,因为禁用隐式缓存的成本是无法接受的。 但使用中转站时应当观察请求日志中的缓存命中率,如果开启隐式缓存后缓存命中率低,成本不降反增,则不应在 AA 中使用该接口。
OpenRouter 推荐使用默认的经典 openai 协议(Chat Completions API),一般不需要指定 protocol 参数。
虽然 OpenRouter 也可以支持
responses协议,但并非最佳选择。
OpenRouter 的思考模型可通过 reasoning 字段指定推理参数,示例:
var aiChat = web.rest.aiChat({
    key = "api-key";
    url = "https://openrouter.ai/api/v1";
    model ="z-ai/glm-5.2";
    temperature = 1;
    reasoning = {
        effort: "high" //推理强度
        //exclude = true; //不回显思考过程
    };
    extraParameters = {
        provider={ //自定义模型供应商
            allow_fallbacks=false; //不允许降级到备份供应商
            only=["novita"]; //明确限定一个或多个供应商 Slug (在模型展示页点供应商链接取网址尾部的供应商标识符)
            quantizations=["fp8"] //量化精度限制
        }
    };
})
OpenRouter 会将不同厂商的不同格式的推理明细规范化为 reasoning_details 字段 —— web.rest.aiChat 可自动识别并支持此字段。
如果 OpenRouter 上同一模型不同供应商的价格与延迟有较大差别, 那么可以通过自定义参数 extraParameters.provider 指定供应商。
在 aardio autos 的 AI 设置对话框中,可在自定义参数设置项如下输入 JSON :
{
    "provider":{
        "allow_fallbacks":false,
        "only":["novita"],
        "quantizations":[ "fp8"]
    }
}
这等价于在代码中指定 extraParameters 参数。
OpenRouter 可以在附加参数中指定 session_id 以优化缓存命中率。
例如:
aiClient.extraParameters = {
    session_id = "my-agent-session-2.1";
}
OpenRouter 会将 session_id 与用户与模型锁定,因此对于单用户+固定的系统提示词缓存优化,通常只需要指定简单的字符串。
OpenRouter 的 session_id 并不能代替大模型的缓存 key 参数 。
虽然 OpenRouter 实际可能做了某些适配和优化,但更稳的做法是添加这些参数。
OpenRouter 对于不支持的参数只会静默丢弃而不会报错,因此这是有利无弊的做法。
例如同时指定 GPT 的 prompt_cache_key 或者 Grok 的 HTTP 请求头 x-grok-conv-id 。
Ollama 本地模型在 aardio 或 ImTip 中的接口地址写以下任何一个都可以:
http://localhost:11434
http://localhost:11434/v1/
http://localhost:11434/api/
Ollama 只要填网址和模型名称,key不需要指定。
请参考: 自动部署本地 Ollama 模型
示例:
var aiChat = web.rest.aiChat(
    key = '密钥';
    url = "https://api.qnaigc.com/v1";
    model = "z-ai/glm-5";
    temperature = 0.5;
    thinking = { type = "disabled" }
    //protocol = "anthropic" //可选切换为 anthropic 协议
)
七牛云的接口有多个:
https://api.qnaigc.com/v1" 兼容 OpenAI / Anthropic 协议https://api.qnaigc.com/bypass/openai/v1 无转换原厂接口(bypass)OpenAI 协议https://api.qnaigc.com/bypass/anthropic/v1 无转换原厂接口(bypass)Anthropic 协议https://api.qnaigc.com/bypass/vertex/v1 无转换原厂接口(bypass)Google Vertex(Gemini 模型) 协议https://openai.qiniu.com/v1 OpenAI 协议bypass 接口通常更稳定,避免了不必要且可能带来兼容性问题的协议转换过程。默认 aardio 会自动识别接口网址中的
anthropic、vertex关键词并转换为合适的协议(也可以使用参数中的protocol字段显式指定接口协议)。通过七牛的 OpenAI 官方模型请务必选择https://api.qnaigc.com/bypass/openai/v1接口( 这个接口在 aardio 新版会默认选择responses协议,可完美透传思维链 )
七牛云接口部分模型支持用 reasoning.effort 或 thinking.type , thinking.budget_tokens 自定义思考模型或强度。或者直接用 extraParameters.thinking 或 extraParameters.reasoning_effort 指定附加参数也可以。
示例:
var aiChat = web.rest.aiChat( {
    key = "密钥";
    url = "https://open.bigmodel.cn/api/paas/v4";
    model = "glm-5.2";
    temperature = 0.5;
    reasoning = {effort = "high"}; //推理强度
})
GLM 5.2 已经支持通用的推理强度参数,
reasoning.effort( OpenAI 接口的 reasoning_effort )兼容 max xhigh high medium low minimal none 等参数。
GLM 在思考模式下并未像其他思考模型那样锁定或限制 temperature 参数, 但最好不要过大过小(一般建议 0.3~0.5)。
魔搭使用 OpenAI 接口,示例:
aiChat = web.rest.aiChat(
    key =  "密钥";
    url = "https://api-inference.modelscope.cn/v1";
    model = "deepseek-ai/DeepSeek-V4-Pro";
    temperature = 1;
    reasoning:{
        "effort":"high"
    }
)

// 可显式声明要记录的 HTTP 响应头
aiClient.responseHeaders = {
    "modelscope-ratelimit-requests-limit"=true; //用户当天限额
    "modelscope-ratelimit-requests-remaining"=true; //用户当天剩余调用次数
    "modelscope-ratelimit-model-requests-limit"=true; //模型当天限额
    "modelscope-ratelimit-model-requests-remaining"=true; //模型当天剩余调用次数
}
魔搭文档虽然有写例如对于reasoning模型,调用的方式与标准 LLM 会有一些细微区别,
但未写明到底有什么区别,这可能是指之前需要用 extraParameters = {enable_thinking = true} 开启思考模式。
但当前魔搭的 GLM-5.2,DeepSeek-V4-Pro 等多个模型,都实际兼容更通用的 reasoning.effort 参数(即 OpenAI 参数: reasoning_effort)。reasoning.effort 指定为 none 可以关闭思考,指定为 high 等参数可以打开思考。
火山方舟平台大模型(豆包、DeepSeek 等)的接口以及智能体接口都兼容 OpenAI 接口。火山智能体的接口地址为 https://ark.cn-beijing.volces.com/api/v3/bots,大模型接口地址为 https://ark.cn-beijing.volces.com/api/v3,模型参数可以填模型 ID 或智能体应用 ID。
import web.rest.aiChat;
var aiChat = web.rest.aiChat(
    key = '密钥';
    url = "https://ark.cn-beijing.volces.com/api/v3";
    model = "doubao-seed-evolving";
    temperature = 1;
    reasoning = {effort="high"}; //自动转换为 reasoning_effort
    // thinking = {type="enabled"};
    // maxTokens = 32768; //方舟 Chat Completions API 自动转换为 max_completion_tokens
     protocol:"responses"
)
对于火山方舟的 doubao-seed-evolving 模型,请使用 responses 协议。
如果使用 openai协议()
如调用火山智能体,将上例网址改为 https://ark.cn-beijing.volces.com/api/v3/bots,并将 model 改为智能体应用 ID。
示例:
import web.rest.aiChat;
var aiChat = web.rest.aiChat(
    key = '密钥';
    url = "https://dashscope.aliyuncs.com/compatible-mode/v1";
    model = "qwen-coder-plus";
)
需要明确几个基础概念:
上下文轮数 指的就是一次对话流(Chat)可以容纳的最大轮次(这通常是一个近似值,执行环境可能会为自动插入的上下文预留位置)在交错思考的过程中自动发起多次请求时需要回传思考内容(推理过程),而在一轮用户对话(包含交错思考与工具调用自动发起的多次请求)结束后,通常应当丢弃这些思考内容(推理过程)。在多轮对话的上下文中仅保留 AI 回复的正文(不应包含推理过程)。即使用户继续对话,上一次的思考过程也应当被丢弃(否则上下文会迅速膨胀,多轮对话难以正常继续下去)。
交错思考的实现并没有统一的标准,各家的实现都不一样,web.rest.aiChat 则尽可能地兼容了不同的实现。
一些模型旧版本的交错思考功能并不完善,尽量使用它们的最新版本以避坑
最佳实践是:对于使用 web.form.chat 等 AI 对话前端界面,建议由界面线程的 web.form.chat 保存对话记录。
而在工作线程中单独创建新的 web.rest.aiChat 发送对话请求。对于支持交错思考的接口,web.rest.aiChat 会自行维护对话记录,并在对话记录中保存推理过程(思考过程)。因为 aardio 的线程隔离特性,这些推理过程并不会被自动添加到界面线程(例好 web.form.chat 对象的 chatMessages 属性),在工作线程中我们可以手动调用 web.form.chat 的 assistant 方法存储一些必要的工具调用结果到界面线程。在一轮用户对话结束后退出工作线程,这些思考过程将被自然丢弃。
完整的实现请参考 Autos 源码 。Autos 的工具实际是由标准库 autos.tools.handlers(工具实现),autos.tools.schemas(工具定义) 提供。而 autos.tools.handlers 中几个关键的代码编辑工具则基于标准库 textkit.patch, textkit.editor 。
注意不是所有大模型接口都支持 function calling 。如果服务端报错缺少 content 字段,这通常是因为接口不支持 function calling,只能处理包含 content 的普通消息。
首先在创建 AI 客户端时,在参数中使用 tools 字段指定允许被 AI 调用(function calling)的本地函数。
tools 应当指定一个数组,数组的每个成员指定一个函数定义,细节可参考调用的大模型相关文档。
示例:
var aiChat = web.rest.aiChat(
    key = "密钥";
    url = "https://api.*****.net/v1";//接口地址
    model = "模型名称";
    temperature = 1;
    tools = { //关键在于增加 tools 字段声明可以调用的本地函数,细节请参考 API 文档。
        {
            "type": "function",
            "function": {
                "name": "getWeather",
                "description": "获取给定地点的天气",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "location": {
                            "type": "string",
                            "description": "地点的位置信息,比如北京"
                        },
                        "unit": {
                            "type": "string",
                            "enum": {
                                "摄氏度",
                                "华氏度"
                            }
                        }
                    },
                    "required": {
                        "location"
                    }
                }
            }
        }
    }
)
然后我们需要在 aiChat.external 表里定义允许 AI 调用的同名函数,与前面的 tools 里声明的函数名称与原型说明要匹配。
示例:
//导出允许 AI 调用的函数
aiChat.external = {
    getWeather = function(args){

        /*
        要特别注意修 AI 可以看到你对 args 参数的改动。
        如果对 args 的修改会让 AI 困惑,则应使用 args = table.clone(args) 复制副本然后仅修改副本。
        */

        console.log("正在调用函数,参数:",args.location,args.unit)

        // 如果直接返回文本,可用自然语言描述清楚。
        return  args.location + "天气晴,24~30 度,以自然语言回复不要输出 JSON"

        // 也可以返回其他数据类型,例如对象或数组。
        return {
            // result,succeeded,error 这些常用的字段无需解释
            result = "返回值";
            succeeded = true;
            error = err;
            comment = "可选在这里添加说明"
        }
    }
}
然后创建对话消息队列,示例如下:
//单独 创建 AI 会话消息队列以保存聊天上下文。
var chatMsg = web.rest.aiChat.messages();

//添加用户提示词
chatMsg.prompt("杭州天气如何?" );
最后发送请求启动对话:
console.showLoading(" Thinking ");

//调用聊天接口。
var ok,err = ai.messages(chatMsg,console.writeText);
长时间执行工具的 Agent 可能在同一轮内积累大量思考与工具结果。messages() 默认在服务器明确拒绝输入上下文过长时,尝试有损裁剪最早的完整工具单元后重新请求;流式和非流式均支持。这不是日常压缩,也不额外调用模型生成摘要。
Responses API 例如以下错误会直接进入该抢救路径:
{"code":"context_length_exceeded","message":"Your input exceeds the context window of this model. Please adjust your input and try again."}
Responses 流式的扁平 error 事件会保留整个错误对象;response.created、response.in_progress 等生命周期事件不会阻止随后 response.failed 的上下文裁剪重试。
openai、responses、anthropic、google、vertex。按当前协议和工作队列的真实结构处理,不根据错误文字猜测协议。tool_calls 和全部配对的 tool 结果;Google/Vertex 的工作队列也采用此格式。Responses 则保持原生 reasoning/message/function_call/function_call_output 单元;Anthropic 保持原生思考、客户端及服务端调用、结果和 caller 依赖单元。function_call_output 本身也可能超过上下文窗口,不能因为它是最后一组就永远保留。未配对完成的单元、含未知原生结构的单元不主动裁剪。保留的思考、签名、密文、工具参数和结果不作字段级截断。max_tokens 限制不触发此机制。已经开始返回内容的流式请求不自动整体重发,避免重复输出或工具副作用。调用方可关闭自动抢救,或记录裁剪统计和更新临时检查点:
import web.rest.aiChat;
var ai = web.rest.aiChat(
    url = "https://api.example.com/v1";
    key = "<api_key>";
    model = "<model_id>";
    protocol = "openai";
    autoTrimContext = false; //省略时启用;也可写 ai.config.autoTrimContext = false
);

ai.onContextTrim = function(workMessages,info){
    //可在此更新临时异常恢复检查点,不要写入普通 UI 历史。
    //info: protocol,attempt,removedGroups,removedMessages,beforeBytes,afterBytes,removedBytes
    //明确 return false 阻止此次自动重试;无返回值则继续。
};
ai.lastContextTrim 保存最近一次裁剪的统计(不会随普通请求自动清零)。onContextTrim 在裁剪完成后调用;整个抢救过程结束后,流式输出再按原约定发送最终 writeDelta(null)。
边界:这是尽力而为的有损抢救,不保证任务语义完全不变,也不能替代所有厂商的原生压缩。某些模型的签名绑定完整消息前缀,裁剪旧单元后即使保留的签名未改动,也可能被服务器拒绝;跨单元引用同样可能依赖已经删掉的早期材料。本机制不伪造签名,不为绕过此类错误而自动清空最近思考。若普通提示本身已经超限,或者没有可识别的完整单元,会返回错误,保留剩余工作队列,不会清空会话;完整工具单元即使是最后一组,也会在持续收到明确上下文超限错误时被删除。
独立使用本地工具、服务端续传或此抢救机制时,请给 messages() 传入与 UI 历史分离的工作队列。这些机制会原位调整工作数组,但裁剪不会修改保留下来的消息对象;需要完整留存原始工具轨迹的应用应自行保留副本。
如果需要更好的效果,则建议在 AI 提示词中添加更多的信息,例如让 AI 知道目标进程的文件名,并要求 AI 根据不同的程序给出更合适的解答,完整示例请参考: 范例 - 超级热键调用 AI 大模型自动续写补全
aardio 基于上面的范例已经内置了 F1 键 AI 助手,运行效果:

利用 F1 键还可以在 aardio 中调用 AI 写其他编程语言的代码,例如写 Python 代码:

在调用 AI 续写补全时,清晰的提示很重要。例如上面我们简明扼要地通过变量命名与注释让 AI 明确 pyCode 里放的是 Python 代码。在编码补全时,在清晰的注释提示后面补全有更好的效果。 注意用法,那么在 aardio 环境中调用 AI 写前端代码、Python 代码、 Go 语言的代码的效果会很好,利用 AI 可以更好地利用 aardio 在混合语言编程上的优势。
如果是用于 aardio 编程的 AI 助手推荐使用 aardio 提供的 VIP 专属接口,aardio 提供了专业版知识库,匹配速度更快,也更加智能与准确。
请参考 OpenAI(Responses) 服务端联网搜索工具 Anthropic 服务端网页搜索
Tavily 搜索质量不错,而且只要注册账号就可以获取每月搜索 1000 次的免费额度,一般够用(响应比 Exa 慢)。
示例:
//导入 Tavily 搜索接口
import web.rest.jsonClient;
var http = web.rest.jsonClient();
http.setAuthToken("接口密钥");
var tavily = http.api("https://api.tavily.com");

//搜索,不建议指定 include_raw_content 参数( 返回的 raw_content 可能有乱码 ).
var resp = tavily.search(
    query = "aardio 如何读写 JSON",
    max_results = 3, //限制返回结果数,默认值为 5。
    //topic = "news", //限定返回最新数据
    //time_range = "month", //搜索最近一个月发布或更新的内容
    include_domains = ["www.aardio.com"] //可选用这个字段限定搜索的域名数组
)

//创建对话消息队列
import web.rest.aiChat;
var msg = web.rest.aiChat.messages();

//将搜索结果添加到系统提示词
msg.url(resp[["results"]])

//添加用户提示词
msg.prompt( "DeepSeek 有哪些成就" );
请参考tavily 文档
一般需要根据用户的最后一个提示词进行搜索,并将搜索结果添加到最后一个用户提示词之前。
//导入 Exa 搜索接口
import web.rest.jsonClient;
var exaClient = web.rest.jsonClient();
exaClient.setHeaders({ "x-api-key":"接口密钥"} )
var exa = exaClient.api("https://api.exa.ai/");

//搜索
var searchData,err = exa.search({
    query:"DeepSeek 有哪些成就",
    contents={text= true}
    numResults:2,
    includeDomains:{"www.aardio.com"},//可以在指定网站内搜索
    type:"keyword" //一般 keyword 搜索就够了(价格低一些)
})

//创建对话消息队列
import web.rest.aiChat;
var msg = web.rest.aiChat.messages();

//将搜索结果添加到系统提示词
msg.url(searchData[["results"]])

//添加用户提示词
msg.prompt( "DeepSeek 有哪些成就" );
exa.ai 的搜索质量不错。
import web.rest.aiChat;
var msg = web.rest.aiChat.messages();

import web.rest.jsonClient;
var dsClient = web.rest.jsonClient();
dsClient.setAuthToken("接口密钥")
var ds = dsClient.api("https://api.deepseek.com/v1/tools/");

//搜索网页
var searchData,err = ds.search({
    query:"DeepSeek 最新版本 after:" + tostring(time.date().addMonths(-1)),
    count:2,
})

//将搜索结果添加到系统提示词
msg.url(searchData[["results"]])

msg.prompt( "介绍 DeepSeek 最新版本" );
import web.rest.aiChat;
var msg = web.rest.aiChat.messages();

var bochaClient = web.rest.jsonClient();
bochaClient.setAuthToken("接口密钥");

//导入博查搜索接口
var bocha = bochaClient.api("https://api.bochaai.com/v1/{method}-search");

//搜索
var searchData,err = bocha.web({
    "query": "DeepSeek 最近有哪些新闻事件",
    "freshness": "noLimit",
    "answer": false,
    "stream": false,
    "count": 2;
})

//添加到系统提示词
msg.url(searchData[["data"]][["webPages"]][["value"]])

msg.prompt( "DeepSeek 最近有哪些新闻事件" );
HTTP 服务端关键代码如下:
var apiKey = request.headers["authorization"]
if(apiKey) apiKey = string.match(authorization,"\S+\s+(\S+)");

if(!apiKey){
    response.errorStatus(401);
    return;
}

// ...... 其他代码省略

import web.rest.aiChat;

// 获取客户端请求的参数
var requestData = request.postJson()

var aiChat = web.rest.aiChat(
    key =  'API_KEY'; //上游接口的 APK key
    url = "https://generativelanguage.googleapis.com/v1beta";
    model =  "gemini-3.6-flash";
    temperature = requestData.temperature;
    maxTokens = requestData.max_tokens;
    tools = requestData.tools;
    reasoning = {
        effort = "high";
        maxTokens = -1;
    }
    protocol = "google";
)

var resp,err = aiChat.messages(requestData.messages,
function(deltaText,reasoning){

    if(!(deltaText || #reasoning) ){
        response.eventStream({data = {"DONE"}});
        return;
    }

    response.eventStream({
        data = {
            choices = {{
                delta = {
                    content = deltaText;
                    reasoning_content = reasoning;
                }
            }}
        }
    });
});

if(err){
    response.error(err)
}